一个 Runtime Measurement 模块,往往从两次读时钟开始。随着 ISR 嵌套、多核、固定窗口和函数重入加入,问题逐渐变成:谁拥有这段时间?谁可以修改状态?输出的是调用耗时还是实际 CPU 时间?
embedded-runtime-observer 的第一版选择一个小的 C99 核心,把这些契约写清楚,再让具体 OS 和硬件提供事件。它能在 PC 上运行,也能由裸机或 RTOS 适配;真实 TC397 接入仍需单独验证。
这是专题的架构篇。建议先阅读CPU Load 与 Idle/ISR 的时间归属。
1. 先决定哪些能力值得自己实现
现有工具已经覆盖了大量采集和分析工作:
| 方案 | 本次参考的分工 | 选择 |
|---|---|---|
| TraceRecorder | 官方 ISR 公共接口包含每核嵌套栈、结束后的切换状态 | 参考模型,不移植整个生态 |
| barectf | 由生成器提供 CTF 编码,平台提供时钟与存储 | 保留为后续格式组件 |
| Zephyr Tracing | 事件格式和输出 backend 分离 | 参考分层,不依赖 Zephyr 内核 |
| Trace Compass / Perfetto | Host 分析和显示 | 作为消费端,不带入 MCU 核心 |
| SystemView | 目标事件与 Host 工具形成闭环 | 技术比较;实际使用遵循对应许可 |
这是面向本项目需求的取舍,并不表示成熟工具无法完成在线测量。若已有稳定的 RTOS port 和分析界面,直接采用它们通常更省工作。
本项目自行实现的部分限定为:执行状态、时间归属、窗口切分、静态指标和可关闭的事件缓冲。 完整 GUI、传输协议和多种二进制格式不进入第一版。
2. 核心只接受事实事件
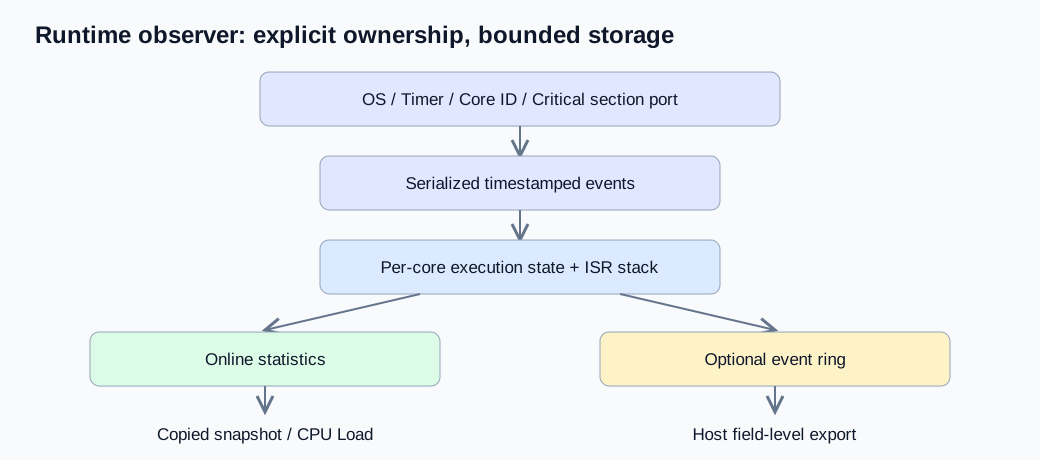
核心 API 接收显式时间戳,而不去查询 STM,也不直接调用 OS API:
rtm_task_switch(&core, now, task_id);
rtm_isr_enter(&core, now, isr_id);
rtm_isr_exit(&core, now, isr_id);
rtm_point_begin(&core, now, point_id);
rtm_point_end(&core, now, point_id);
因此可以用 Mock Clock 把输入固定为 10、20、30、50,测试结果无需依赖真实调度。Timer、Core ID、ID 映射、临界区和 OS Hook 留在 port。接口不会要求 Os.h 或 MCU SDK。
单次事件先把旧上下文结算到 now,再修改执行状态。这样同一时间边界只归属一次;新执行者从这个边界开始。
3. 每个核维护自己的 ISR 栈
Task/Idle/Kernel 是被中断时保留的底层执行者。进入 ISR 时压栈,退出时要求 ID 与栈顶一致,再恢复下层。
exclusive 时间只累计到正在运行的最上层 ISR;inclusive 累计到所有活动 ISR 帧。即使同一 ISR ID 重入,两个调用帧也分别保存自己的开始/累计状态。
如果 ISR 唤醒了不同任务,事件模型采用两步:先退出最外层 ISR,再在真实 dispatch 边界切到新任务。core 禁止在 ISR 栈未清空时直接切 Task。具体 OS 若把 Hook 放在不同顺序,适配层应先规范化事件。
不匹配的出口、非法 ID 或栈满会标记当前观察 epoch 无效。此后冻结测量并保留诊断,只有在已知状态下 reset 才重新开始;不能“忽略一个错误后继续输出精确负载”。
4. 函数点不能共享一个全局栈
假设 Task A 进入函数点 P,随后被 ISR 抢占,而 ISR 也进入 P。如果只用 start[P],ISR 会覆盖 A 的开始值。
第一版为每个 Task、Idle/Kernel 和每层 ISR 调用分别维护函数栈。函数点允许递归,重复 Begin 表示新的嵌套调用;End 必须匹配当前执行者的栈顶。Task 被阻塞或抢占时,它自己的函数栈保留。
这也明确了指标的含义:函数 inclusive 包含其嵌套函数;exclusive 扣除嵌套函数;两者都只记录所属执行上下文拥有 CPU 的时间,排除其他任务、中断抢占和阻塞。它们不是调用者体感的 wall latency。
Task 迁移、跨上下文 End,以及从 Hook 次数推算 Activation 都不在第一版范围内。需要 Activation/Runnable 的 CPU 时间时,在真正的业务边界放独立 Point ID。
5. 固定窗口与采样契约
窗口不会让当前调用结束。poll/snapshot 只将运行时间分配到相邻窗口,继续保留 ISR 与函数帧。
为保证事件处理有界,配置满足 max_gap <= window_ticks。一次调用最多分成两个累计片段、关闭一个窗口。port 按短于 max_gap 的周期采样;如果明显超期,则使本轮测量无效,不在 Hook 中执行无限制“补算过去一百个窗口”。
窗口使用 64 位长度,输入时钟可以是 32 位。当前部分窗口和最近完整窗口保留在状态中;历史窗口由报告路径保存。读者可以用窗口编号发现自己错过了输出,不把最后一个窗口误认为全部历史。
6. per-Core 不等于线程安全
每核独立对象解决跨核共享写入,但同核 Task 和嵌套 ISR 仍可能交错。一个重要的 port 顺序是:
- 保存并建立合适的中断屏蔽状态;
- 读取硬件时间;
- 更新 core 或复制 snapshot;
- 恢复先前屏蔽状态。
如果先读时钟再加保护,更高优先级写者可能已经提交更新,旧时间戳才到达 core。仅给更新操作上锁,仍不能保证事件时间有序。
跨核汇总采用拥有者生成副本,再通过已核查的 IOC/消息协议发布。无保护读取活跃 64 位计数不属于合法用法;NonCached 或 volatile 也不能代替同步。各核 snapshot 还需要明确各自 epoch 和范围,未校时的数据不能声称为同步全局快照。
7. 小核心可以有明确的成本
核心不分配、不打印、不传输、不等待锁。累计开销与静态 ISR/函数深度相关;snapshot/reset 的成本与编译容量相关。它不是“一律 O(1)”的口号,而是由明确上限约束的工作量。
Host 默认配置每核结构体 11,144 字节;将 Task/ISR/Point 容量各设为 8,深度设为 4,关闭 Trace 后为 3,504 字节。真实目标 ABI 的大小、Flash 与最大屏蔽时间仍需重新测量。
Trace 缓冲与统计解耦。满时丢弃新事件并增加 loss 指标,CPU 统计继续。导出按字段编码,不直接把带 padding 的结构体内存当文件格式。当前 Host 工具输出 Perfetto/Chrome 的即时事件 JSON,没有实现 CTF/BTF,也没有重建精确 slice 或校准跨核时钟。
8. 用反例和不变量验证
37 个核心场景覆盖 Idle、Task、ISR 抢占、嵌套、同 ID 重入、跨窗口、回绕、深度溢出和配对错误。另用独立逐 tick 计数器核验 10 万次随机转换,检查分类守恒,而非只检查代码能运行。
两个模拟核与两个快照读者通过各核 mutex 进行 20 万次序列化操作,ThreadSanitizer 未报告竞态。这验证的是遵守单对象串行契约的 Host 实现;mutex 不是适合直接搬到 MCU ISR 的锁方案。
代码及完整契约见专题源码归档。下一篇讨论TC397/AUTOSAR 的接入与验证,尤其是通用算法正确以后,真实测量还需要哪些工程证据。