CPU 时间与栈空间是嵌入式软件的两项基础资源。CPU Load描述一个核在窗口内的工作比例,Stack Measurement 则记录任务、中断和系统执行路径对栈空间的历史需求。把两类指标放在一起,可以同时观察执行预算与内存裕度。
本文从栈的基本模型讲起,介绍 Stack Painting 和 High-Water Mark,再连接边界监控、TC397/AUTOSAR 接入与开源实现。配套的 Stack Observer 已完成 Host 测试;目标平台的编译、调用权限和硬件对照分别验证。
1. 栈测量与容量规划
栈容量由配置与链接布局决定,运行需求则随调用深度、局部变量、编译优化、中断嵌套及执行路径变化。历史峰值为容量选择提供运行证据,剩余裕度帮助安排后续功能与压力场景。
一份可解释的结果应同时带上容量、峰值、单位、统计对象和有效性。例如:
| 指标 | 模拟值 | 含义 |
|---|---|---|
| Effective Capacity | 2048 B | 扣除保留区与 Guard 后的可观测容量 |
| Peak Usage | 640 B | 当前观察 epoch 内保留的最大水位 |
| Remaining Capacity | 1408 B | 容量减去历史峰值 |
| Usage Percentage | 31.25% | 640 / 2048 × 100% |
这里的 Remaining 表达历史峰值下的裕度。它与当前 SP 所在位置分别描述不同状态;有代表性的测试覆盖、额外设计余量和长期观察,共同支撑工程容量决策。
2. 嵌入式栈的基本模型
Stack Pointer 标识当前执行上下文的栈位置。函数调用建立栈帧,为局部变量、参数和编译器需要保存的数据提供空间,返回后恢复先前位置。具体布局、对齐和保存方式由体系结构与编译器 ABI 决定。
常见布局采用向低地址增长:栈逐渐使用高地址端以下的空间。向高地址增长采用相反方向。测量算法必须知道实际增长方向和可用边界。
| 栈对象 | 常见组织方式 | 观测身份 |
|---|---|---|
| Task Stack | 独立任务栈,或调度约束下的共享栈 | 物理区域及使用者映射 |
| ISR Stack | 按核或中断组织,可由多个 ISR 共用 | 核、共享区域与 ISR 用户集合 |
| Kernel Stack | 系统执行路径使用的栈,具体组织由 OS 决定 | OS 定义的实际区域 |
逻辑 Task/ISR 数量与物理栈数量可以不同。多个 ISR 共用一个区域时,测得的是该共享区域的峰值。统计模型保留“谁使用这块区域”的映射,报告则以物理区域为单位。
在 TriCore 上,还要把普通 C 栈与 CSA 上下文资源分开。上下文保存并非全部落在普通栈内,两个资源使用不同单位和观测方法。
3. Stack Painting 与历史水位
Stack Painting 在安全初始化阶段,用固定图案填充尚未使用的栈空间。执行过程中的写入改变部分图案,之后从最深的可用端扫描,定位第一个已经改变的单元,得到水位。
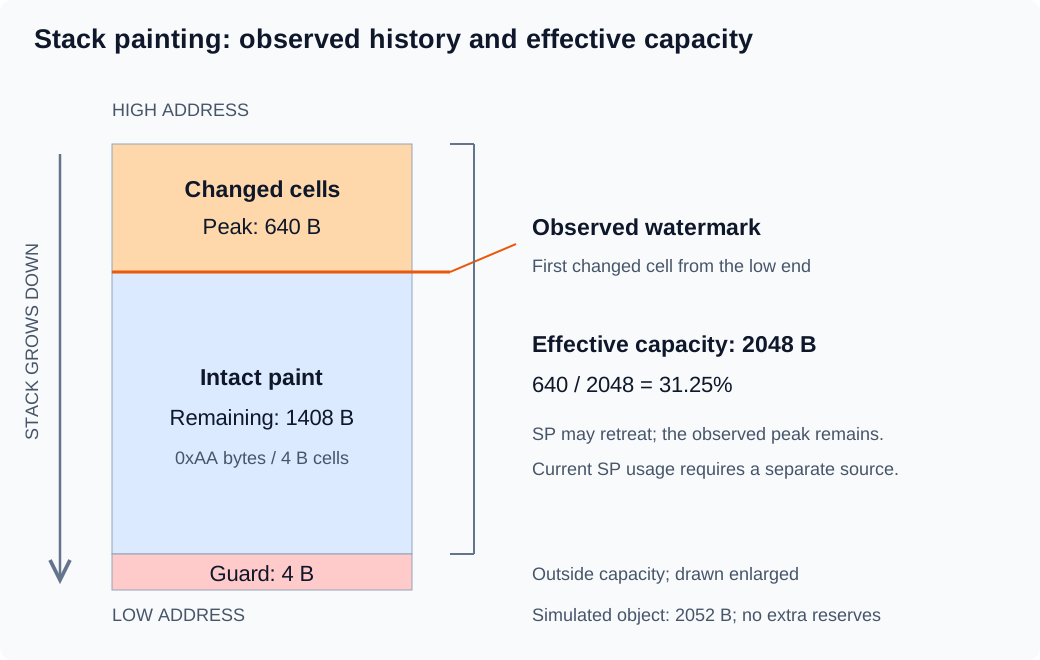
图中高地址端有 640 B 被写入,低地址端仍有 1408 B 保持图案;4 B Guard 位于有效容量之外。图示将 Guard 放大以便阅读,使用区与未改变区按容量比例绘制。这个模拟对象共 2052 B,没有额外保留区。
数值计算保持同一个分母:
Capacity  = 2052 − 4 = 2048 B
Peak      = 2048 − 1408 = 640 B
Remaining = 2048 − 640 = 1408 B
Usage     = 640 / 2048 × 100% = 31.25%
函数返回后,SP 可以回到较浅位置,原来写入的内存通常仍保留。水位因此适合描述历史需求。观测模块再保留同一 epoch 中已经看到的最大值,直到明确启动新一轮观察。
填充图案是测量标记,不是写入日志。真实数据恰好等于图案,或 SP 为局部数组预留空间却没有写入时,水位可能低估真实深度。它提供“运行后留下了哪些可见痕迹”的证据;当前 SP 测量需要独立、可信的执行上下文来源。
4. 顺序扫描与提前退出
对于向低地址增长的区域,从低地址可用端向高地址扫描。以 4 B 单元为例,每个单元逐字节比较,遇到第一个变化单元即可停止。逐字节读取让通用库兼容未对齐的虚拟存储,也避免通过 uint32_t * 访问任意内存所带来的别名约束。
下面是配套 src/stack.c 中的独立实现片段,同时保留向高地址增长的镜像分支:
size_t cells = stack->last.capacity_bytes / stack->region.cell_bytes;
size_t unused = 0;
while (unused < cells) {
    size_t index = stack->region.direction == RTM_STACK_DOWN
                 ? unused : cells - 1 - unused;
    size_t offset = stack->payload_offset
                  + index * stack->region.cell_bytes;
    ++stack->last.scanned_cells;
    if (!cell_matches(stack, offset)) break;
    ++unused;
}
used = stack->last.capacity_bytes
     - unused * stack->region.cell_bytes;
cell_matches 比较该单元的每个字节与配置图案;部分字节改变时,整个单元计入用量。因此 4 B 粒度给出按单元取整的观察水位,1/2/8 B 配置也采用同一规则。
设容量为 C、单元宽度为 w、最深端连续保持图案的单元数为 U:
| 内存状态 | 实际检查次数 |
|---|---|
| 遇到变化单元 | U + 1 |
| 全部保持图案 | C / w |
| 最深端首个单元改变 | 1 |
2048 B 容量、640 B 峰值、4 B 粒度的例子检查 1408 / 4 + 1 = 353 个单元。未改变的前缀越长,扫描越多;全填充状态是扫描工作量最大的情况。最坏复杂度为 O(C),而不是随峰值增加而增加。
顺序扫描也容纳不连续的图案内容。使用过的区域中可能出现仍等于图案的单元,内存比较结果没有严格单调性,因此首版采用线性扫描。二分查找只有在另一个机制建立并证明了单调不变量时才适用。
5. 水位、边界监控与内存保护
Watermark、Guard 和内存保护分别提供历史需求、边界变化和访问约束:
| 机制 | 提供的信息或行为 | 工程用法 |
|---|---|---|
| Watermark | 可见的历史使用深度 | 容量规划与裕度观察 |
| Guard Word | 检查时发现边界图案变化 | 独立诊断与故障响应 |
| MPU / Memory Protection | 对其覆盖范围内的违规访问施加保护 | 依据实际区域、权限与 Trap 配置落实 |
一个典型过程是:初始化填充有效区域与自有 Guard;执行后记录峰值;周期查询同时检查 Guard;边界变化后把结果标为无效诊断,并交给工程的故障处理路径。
Guard 被检查到变化时,写入已经发生;它本身不阻止越界。跨过 Guard 的写入、图案碰撞或检查间隔,也会影响其诊断覆盖。配置 MPU 时,实际覆盖区间和访问权限决定保护效果,不能仅凭存在某个检查函数就推断工程已经具备栈保护。
有效容量始终扣除平台保留区和观测 Guard。阈值依据 capacity − peak 设置,达到或低于指定剩余量时给出 warning;报告同时保留有效性与 Guard 状态,便于上层采用不同响应。
6. TC397 / AUTOSAR 工程接入
此前提供的 TC397/MICROSAR 工程调查描述了 0xAAAAAAAA painting、4 B 扫描,以及 Task/ISR 栈用量查询。在该案例中,API 返回历史已用字节,跨核路径通过 OS XSignal 服务完成。这里用这一语义说明适配方法;实际函数原型与允许的调用上下文以工程生成头文件和当前 OS 手册为准。
从配置建立物理区域映射
DaVinci 配置和生成结果共同确定 measurement 开关、Task/ISR 对象、栈共享及初始化时序。接入层先建立“逻辑 ID → 核 → 物理栈区域”的映射,并确认查询用量与有效容量描述同一个区间。
共享 ISR 栈映射到同一个 observer,对外标记 shared。配置大小、链接分配大小和可用容量分别核对;保留空间使用实际 TC397 生成定义,不套用其他系列的 Stack Gap 常量。
通过 OS 服务获取样本
Os_GetTaskStackUsage、Os_GetISRStackUsage 在此作为 Vector 供应商扩展的接入点。应用包装层校验初始化完成、ID、核归属、权限与调用级别,再把结果归一化为峰值已用字节。
其他 OS 可以采用不同语义。例如 FreeRTOS 高水位 API返回任务创建以来的最小剩余栈空间,单位为 word。归一化时使用实际的 sizeof(StackType_t),再由有效容量减去最小剩余字节,得到峰值已用字节。
周期查询与调试对照
CDD 或低优先级报告任务按预算轮询区域,把 observer 结果复制后发布。跨核查询可能等待远端服务,因此必须保持其所需的进度条件,并在目标上测量同步等待时间。时间事件的本核中断保护不能直接套在可能依赖 XSignal 中断推进的查询外层。
WinIDEA 对照可以在获准、静止的区域观察图案边界,与 OS 返回值比较。对照记录同时包含地址范围、单元宽度、运行路径和调试暂停条件,便于解释结果。这里没有新执行 TASKING 构建,也没有 TC397/WinIDEA 硬件实测。
CSA 采用独立资源模型
TriCore CSA 使用 64 B 上下文块,FCX、LCX 和 PCXI 参与上下文链及耗尽处理。Infineon 架构手册与上下文耗尽说明给出了对应语义。
未来 CSA Observer 可以提供容量、剩余块数与低水位,并建立拥有者核一致采样、合法地址和有界链遍历协议。CSA 的块数保持独立,不合并到普通 C 栈百分比;本版只记录设计边界。
7. 可移植 Stack Observer
配套框架在原有时间核心旁增加 rtm_stack 库。每个对象由调用者持有,无全局注册表、动态分配或 Trace 依赖:
| 模式 | 数据来源 | 初始化与权限 |
|---|---|---|
| Application-owned | 应用明确拥有的静止内存 | 安全离线 painting;按边界扫描 |
| OS-managed | 合法 OS 查询回调 | descriptor 不持有栈地址;不直接扫描或 painting |
没有合法 OS 查询时返回 Unsupported。库不通过私有 OS 布局获取数据;供应商头文件、ID 和访问规则都留在适配包装层。
公共接口只有四个操作:rtm_stack_init 绑定区域,rtm_stack_paint 初始化应用区域,rtm_stack_measure 获取新样本,rtm_stack_snapshot 复制缓存结果。结果一次给出 capacity、peak、remaining、percentage、valid、warning 和 guard。当前 SP 后端尚未提供,current_status 明确为 RTM_STACK_E_UNSUPPORTED。
下面的代码使用静态虚拟数组演示实际 API:
#include "rtm/stack.h"
#include <string.h>
static unsigned char memory[2052];
static rtm_stack_t observer;
rtm_stack_region_t cfg = {0};
rtm_stack_usage_t s;
cfg.memory = memory;
cfg.region_bytes = sizeof(memory);
cfg.cell_bytes = cfg.guard_bytes = 4;
memset(cfg.fill_pattern, 0xaa, sizeof(cfg.fill_pattern));
memset(cfg.guard_pattern, 0xde, sizeof(cfg.guard_pattern));
if (rtm_stack_init(&observer, &cfg) != RTM_STACK_OK) return 1;
if (rtm_stack_paint(&observer) != RTM_STACK_OK) return 2;
memset(memory + 4 + 2048 - 640, 0x55, 640); /* 模拟执行写入。 */
if (rtm_stack_measure(&observer, &s) != RTM_STACK_OK) return 3;
Observer 状态与输出放在测量区域之外。所有对象操作与应用 buffer 写入由调用者串行化,扫描期间源内存保持静止;volatile 读取不承担同步职责。生产接入把查询放在允许的报告上下文,通过 IOC 或消息发布完整副本。
API 指南详细定义了边界、epoch、失败样本和单位转换。AUTOSAR 接入文档进一步说明共享映射与目标验证步骤。
8. Host 实践与扫描预算
完整示例可以直接运行:
git clone https://github.com/binkyle/autosar-module-lab.git
cd autosar-module-lab/embedded-runtime-observer
make test
./build/stack_simulator
./build/stack_autosar_concept
make stack-benchmark
Simulator 的实际输出是模拟栈结果:
Simulated Stack Capacity : 2048 B
Peak Usage : 640 B
Remaining : 1408 B
Usage : 31.25%
After simulated SP retreat: peak=640 B, current=unsupported, guard=intact
Independent region: peak=0 B
Synthetic guard damage: detected, valid=0
39 个栈契约场景覆盖全填充、部分与全部使用、历史峰值、双向增长、各单元宽度、未对齐内存、保留区、Guard、OS 只读和单位转换。8,000 次随机操作通过独立字节 oracle 核验,两区域/四线程完成 20 万次串行化操作。原有 37 个时间场景、随机转换、并发测试及示例同时通过回归;ASan/UBSan 检查也已执行。
Linux x86-64、GCC 13.3、-O2 的一次基准覆盖 1/2/8/16 KiB,各容量测试 0%、25%、50%、约 90% 和 100% 峰值。每组预热 200 次,计时 10,000 次,使用 4 B 单元和 4 B Guard:
| 有效容量 | 全填充平均 | 全填充最大观察值 | 首单元改变平均 | 首单元改变最大观察值 |
|---|---|---|---|---|
| 1 KiB | 0.636 µs | 91.508 µs | 37.05 ns | 13.871 µs |
| 2 KiB | 1.416 µs | 302.655 µs | 37.07 ns | 0.041 µs |
| 8 KiB | 5.425 µs | 969.510 µs | 38.84 ns | 18.017 µs |
| 16 KiB | 10.129 µs | 248.514 µs | 37.43 ns | 12.459 µs |
原始数据包含计时调用、扫描、Guard、统计与 Host 调度噪声;本次计时对平均约 24.05 ns。全填充时,扫描成本随容量增加;首单元改变时,扫描立即结束。最大观察值显示了调度噪声的影响,不能作为 WCET,也不能换算成 TC397 实测时间。
实际工程先测合法 OS 查询与报告成本,再选择周期、分批数量和输出节奏。验证记录保存全部 20 组数据与复现方法。
9. 从资源指标到工程预算
时间观测把执行过程组织成每核时间账本,栈观测把运行留下的内存水位转化为容量与裕度证据。两者使用独立采集路径,通过一致的区域身份、单位、有效性和副本发布方式连接到报告层。
从物理区域映射开始,明确 painting 或 OS 查询的所有权,核对有效容量,再结合代表性负载、边界监控和目标成本测量,就能逐步建立可持续的资源观测方法。开源 Host 模型提供可复现基线,实际 OS 与硬件验证为工程应用补齐最后一段证据。
继续阅读:CPU 时间模型 · 框架设计 · TC397 平台接入 · 专题目录。